curl 下载页面变乱码?核对压缩请求与自动解压
把浏览器里的请求头复制到 curl 后,保存的“网页”却像一串二进制内容,问题可能出在压缩处理,不一定是机场传坏了数据。请求压缩与解压正文需要分开核对。
这篇适合检查小型公开 HTML 或文本资源。不要把账号页面、订阅响应和含令牌的请求复制到示例中,也不直接向论坛提交完整响应。
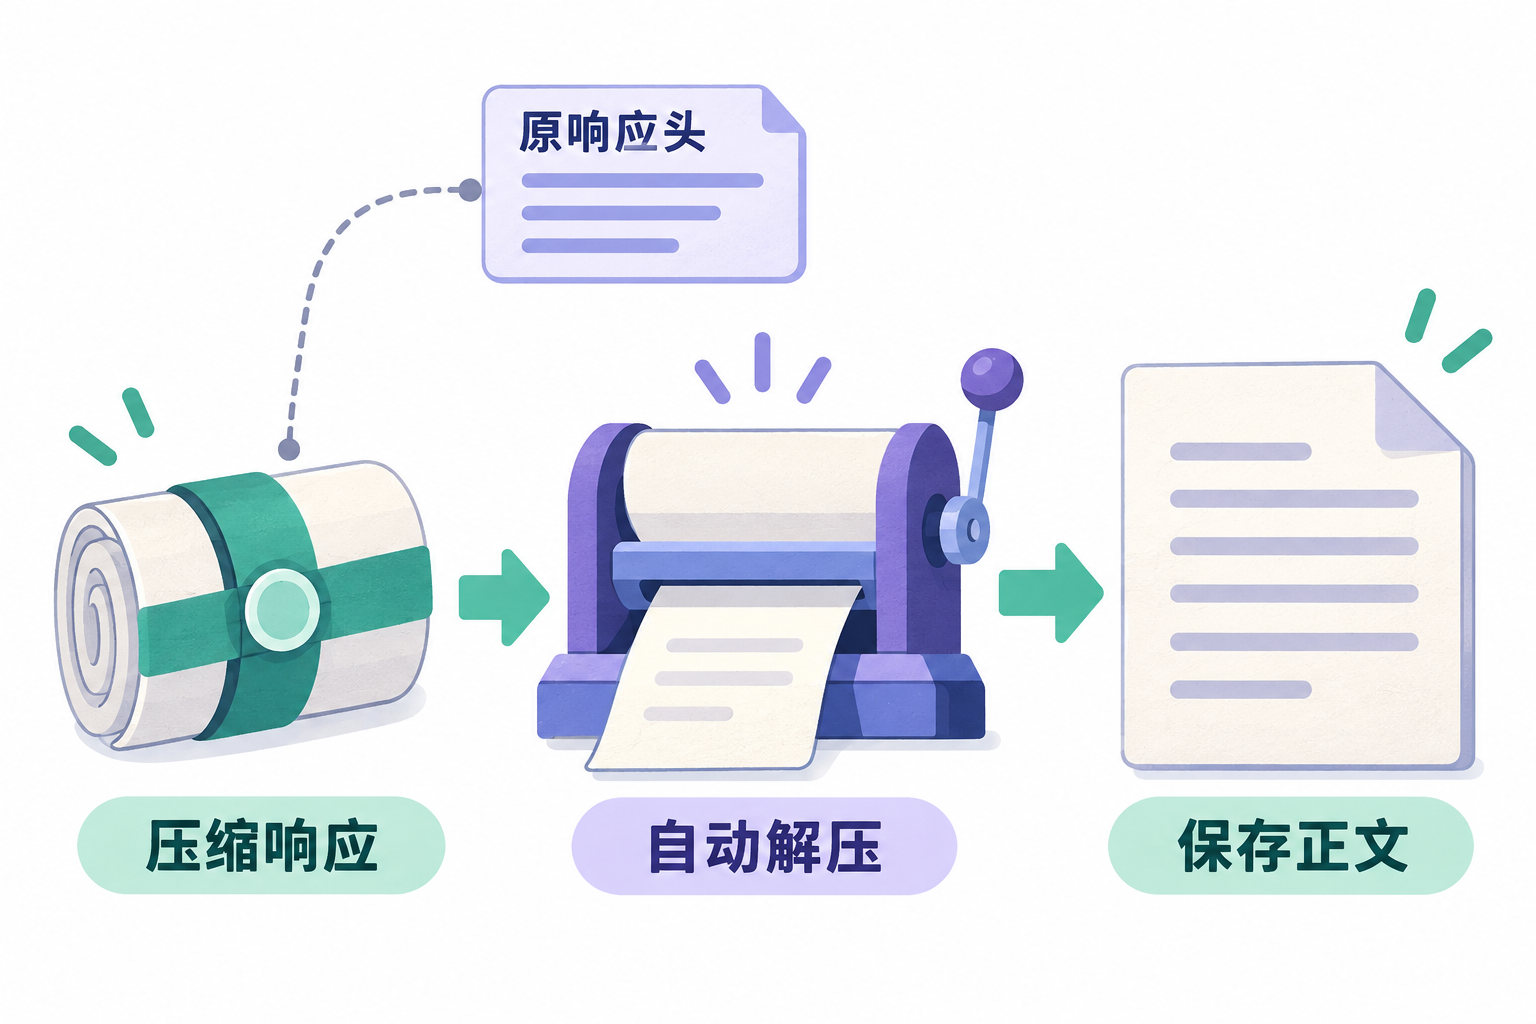
示意图:响应头记录与已经解压的保存正文需要分别理解。
先看两类编码提示
| 字段或选项 | 核对的层次 |
|---|---|
| Accept-Encoding 请求头 | 客户端向服务端表示可接受的压缩方式 |
| Content-Encoding 响应头 | 本次响应正文采用的内容编码 |
| --compressed | curl 请求支持的压缩,并对收到的内容自动解压 |
| Content-Type 中的 charset | 正文作为文本时的字符编码信息 |
curl 官方手册说明,--compressed 会自动解压内容;保存的响应头保持原样,因此头部仍写压缩,不代表落盘正文尚未解压。服务端也可以不采用压缩。
不要仅凭“头部出现 gzip”就把文件交给解压程序。先回看命令和正文实际状态,再判断是否需要进一步处理。
用一条明确的命令建立基线
下面是公开小页面的检查示例,不代表本站已测得该站采用某种压缩:
curl.exe -q --compressed --connect-timeout 10 --max-time 20 --dump-header page-headers.txt --output page-body.html https://example.com/
确认当前目录没有需要保留的同名文件,再运行;如有,换新文件名。page-headers.txt 保存响应头,page-body.html 保存 curl 处理后的正文。命令没有认证信息,也没有跟随跳转。
若目标返回跳转、错误页或非 HTML,先记录真实状态与类型,不把输出扩展名当作正文格式的保证。要核对代理路径时,另使用客户端正式给出的入口,保持其余选项相同。
压缩和字符编码分别排查
先检查命令是否启用了自动解压,再确认 Content-Encoding。自行添加 Accept-Encoding 请求头时,不要以为只发出这个头就完成了整个解压流程;优先用工具明确提供的压缩处理选项。
everything curl 的压缩章节介绍了收到压缩内容后,在保存或输出前解压的流程。与之相比,文字已经可读但中文不正常,下一步应核对文本字符编码及打开文件的方式,而不是继续叠加解压操作。
| 保存结果 | 下一步 |
|---|---|
| 仍像压缩数据 | 回看实际命令、响应编码和工具报错 |
| 已是 HTML,但中文显示异常 | 核对 charset、页面声明与查看工具 |
| 是错误页或登录页 | 核对目标、状态与访问条件 |
| 只有响应头,没有正文 | 核对是否原本使用了 HEAD 等选项 |
怎样避免错误地比较大小
解压后文件大小可能与响应头或网络传输记录对应的大小不同。先注明自己比较的是网络内容、工具保存结果还是文本显示内容,不把它们直接当作同一流量口径。
在机场推荐或排障记录中,保留命令选项、实际状态、内容类型、压缩处理和正文可读性。原任务恢复且编码解释一致,才算完成这轮核对。
来源与核验日期
官方资料核验日期:2026-10-08。本文提供自行操作与记录的方法,不代表本站对某家机场的实测结论。
评论